Graceful shutdown без 502
Перед началом: модули 6–10 (конвейеры, пулы, таймауты, HTTP). Инструменты: Go 1.22+,
dockerилиkubectlдля деплоя. Трудоёмкость: ~4 ч (теория 1.5 ч · практика 2 ч · квиз 0.5 ч).
🔥 Инцидент: деплой раз в час — и каждый раз пачка 502
Сервис выкатывается каждый час — так устроен CI. После каждого
деплоя балансировщик фиксирует всплеск 502: часть запросов
приходит ровно в момент, когда под уже получил SIGTERM, но
приложение ещё не перестало принимать новое и не дообработало
начатое. Одновременно теряются фоновые задачи: воркер писал отчёты
из очереди, процесс завершился — и половина очереди испарилась.
Под умирает по SIGTERM не «за секунду»: у него есть
terminationGracePeriodSeconds, и всё это время приложение обязано
вести себя так, чтобы наружу не ушло ни одного 502, а принятая
работа была либо выполнена, либо честно возвращена в источник.
📖 Теория
11.1 Сигналы: signal.NotifyContext как выключатель
SIGTERM — вежливая просьба завершиться; SIGKILL перехватить
нельзя, поэтому вся надежда на первые секунды. Вместо ручного
signal.Notify и канала используйте signal.NotifyContext: он
возвращает ctx, который отменяется по сигналу, и stop для
освобождения подписки.
goctx, stop := signal.NotifyContext(
    context.Background(), os.Interrupt, syscall.SIGTERM,
)
defer stop()

go func() {
    <-ctx.Done() // сигнал получен — начинаем хореографию
}()
Отменённый ctx — это ещё не остановка: он лишь разрешает
начать остановку. Все долгоживущие горутины должны смотреть на
ctx.Done() и завершаться сами; os.Exit из обработчика сигнала
обходит все defer и превращает graceful в жёсткий.
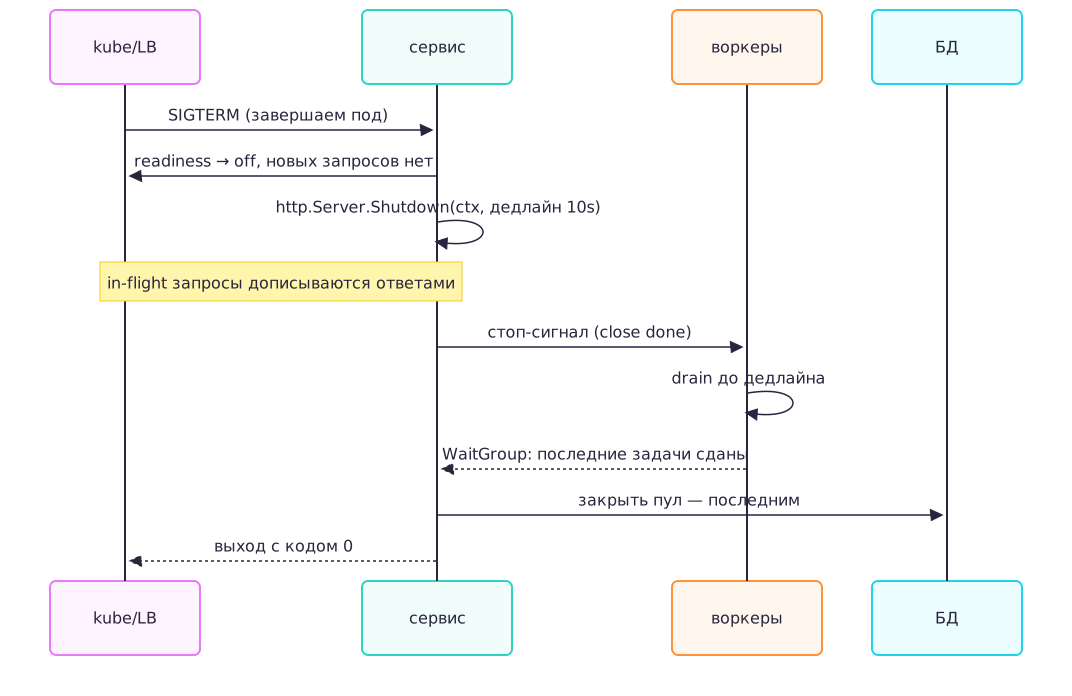
11.2 Порядок: readiness → Shutdown → drain → зависимости
Порядок не декоративный: каждый шаг защищает следующий.
- Readiness off.
/readyначинает отвечать 503, и балансировщик перестаёт слать новое. Это асинхронно: между «выключили readiness» и «перестали приходить запросы» проходит время, поэтому вpreStop-хуке часто ставят паузу на 5–10 с. http.Server.Shutdownс дедлайном. Сервер закрывает слушатели и ждёт завершения in-flight запросов; новые соединения не принимаются.CloseвместоShutdownрвёт активные запросы — это и есть источник 502.- Drain воркеров. Задачи из очереди дообрабатываются до дедлайна; не успевшие фиксируются и возвращаются в источник.
- Закрытие зависимостей — в обратном порядке потоку данных: сначала продьюсеры, затем консьюмеры, БД последней. Если закрыть БД раньше воркеров, drain начнёт сыпать ошибками.
Отдельная ловушка — WebSocket и hijacked-соединения: Shutdown
их не ждёт. Для них нужен свой реестр соединений и собственный
дедлайн закрытия.
11.3 Drain с дедлайном и честный сброс необработанного
Drain — это «дочитать очередь, пока не истёк дедлайн, и честно
признать, что не успели». Дедлайн берётся из бюджета деплоя:
terminationGracePeriodSeconds минус время на Shutdown и
закрытие зависимостей.
Важно не «молча выбросить» остаток, а вернуть его в источник: задача либо остаётся в брокере (если вы читали с ack), либо пишется в outbox или таблицу повторов, либо помечается failed. Счётчик сброшенных задач — обязательная метрика: он отличает «плавный деплой» от «тихую потерю работы».
godeadline := time.Now().Add(grace)
for {
    select {
    case t, ok := <-queue:
        if !ok {
            return // владелец закрыл очередь
        }
        if time.Now().After(deadline) {
            persist(t) // честный сброс: задача не потеряна
            dropped.Add(1)
            continue
        }
        handle(t)
    case <-ctx.Done():
        return
    }
}
11.4 WaitGroup на воркеров: Shutdown не ждёт фон
http.Server.Shutdown возвращается, когда закончились
HTTP-хендлеры. Фоновые воркеры, writer в БД, тикеры — вне его
юрисдикции. Если после Shutdown сразу выйти из main, процесс
умрёт вместе с ними, а вы будете думать, что drain был.
Поэтому у воркеров свой WaitGroup, и главный поток ждёт его
отдельно — тоже с дедлайном, чтобы зависшая задача не держала под
до SIGKILL. Классическая ошибка — wg.Wait() без таймаута: одна
горутина, застрявшая в клиенте без таймаута, блокирует деплой
навсегда.
godone := make(chan struct{})
go func() { wg.Wait(); close(done) }()

select {
case <-done:
case <-time.After(10 * time.Second): // не ждём вечно
    log.Println("drain не успел: остаток сохранён")
}
11.5 Идемпотентность: перезапуск умеет повторять
Graceful shutdown уменьшает окно потерь, но не делает доставку ровно один раз. Причины:
- балансировщик мог отправить запрос, который уже выполнился, но ответ не дошёл — клиент повторит;
- задача обработана, а подтверждение (ack) не сохранилось — после рестарта она придёт снова;
SIGKILLв конце grace-периода обрывает всё, что не успело зафиксироваться.
Значит, обработчики обязаны быть идемпотентными: idempotency key
из запроса, upsert вместо insert, таблица дедупликации или
транзакционный outbox. «Мы сделали graceful shutdown» — не
гарантия доставки, а всего лишь способ не терять работу в штатном
деплое.
11.6 Компромиссы
- Grace-период короткий vs длинный: короткий ускоряет деплой, но увеличивает число оборванных запросов и сброшенных задач; длинный безопаснее, но замедляет выкатку и держит ресурсы.
- Readiness-пауза vs мгновенный
Shutdown: пауза стоит секунд деплоя, но закрывает гонку с балансировщиком; без неё 502 остаются даже при идеальномShutdown. - Дедлайн drain vs бесконечное ожидание: дедлайн ограничивает деплой, но требует честного сброса; бесконечное ожидание превращает зависшую задачу в зависший под.
- Синхронная обработка vs фоновая очередь: синхронная проще и не теряет при рестарте, но удлиняет ответ; фоновая быстрее для пользователя, но требует идемпотентности и хранилища задач.
- Своя хореография vs платформенные хуки:
preStopиterminationGracePeriodSecondsдают базу, но не отменяют необходимость drain внутри приложения.
💻 Практика
- Воспроизведите 502. HTTP-сервер с хендлером на 2 с и
нагрузкой 50 rps. Пошлите
SIGTERMи сравните два варианта:srv.Close()иsrv.Shutdown(ctx)с дедлайном 10 с. Считайте 502 и оборванные соединения на клиенте. - Соберите хореографию.
/readyс атомарным флагом,signal.NotifyContext,Shutdownс дедлайном, drain воркеров, закрытие зависимостей в обратном порядке. Логируйте таймлайн: сигнал → readiness off → последний запрос → drain → выход. - Проверьте честный сброс. Очередь из 100 задач, обработчик медленнее grace-периода. Убедитесь, что необработанные задачи попали в хранилище повторов и посчитаны метрикой; перезапустите процесс и обработайте их повторно.
- Запустите сниппет модуля: он печатает пять шагов хореографии, затем drain очереди из 8 задач с дедлайном в 5 тиков — в выводе будет «обработано 5, сброшено 3».
🧩 Quiz
✅ Итоги модуля
Студент должен:
- Ловить
SIGTERMчерезsignal.NotifyContext - Выстраивать порядок: readiness →
Shutdown→ drain - Ставить дедлайн на остановку и не ждать вечно
- Возвращать необработанное в источник и считать метрикой
- Ждать фоновые воркеры отдельно от
Shutdown - Делать обработчики идемпотентными к повторам
- Объяснить, откуда при деплое берутся 502
- Ответить на все вопросы Quiz
🔗 Мостик к Модулю 12
Корректная остановка спасает свой под, но не спасает от чужой деградации: если партнёрский API перестал отвечать, запросы копятся в хендлерах и таймаутах, пока не съедят пул соединений. Дальше — circuit breaker и bulkhead: как перестать ходить в мёртвый сервис и изолировать ресурсы по зависимостям.