Модуль 2. Паттерны, антипаттерны и «боевые шрамы»
Цель модуля: собрать из знаний о брокерах инженерные решения: кто гарантирует порядок и какой ценой, как не упасть под нагрузкой (backpressure), что делать с poison-сообщениями, как атомарно публиковать события вместе с записью в БД (Outbox), координировать распределённые транзакции (Saga), что мониторить и как корректно останавливать сервисы.
Перед началом: Модуль 1 этого курса; понимание идемпотентности обязательно. Инструменты: Go 1.22+, PostgreSQL, Prometheus + Grafana (docker-compose). Трудоёмкость: ~12–14 ч (теория 4 ч · практика 8 ч · квиз 1 ч).
📖 2.1. Гарантии порядка: per-key, per-partition, глобальный
Уровни и их цена
| Уровень | Как получить | Цена |
|---|---|---|
| Per-key | ключ сущности → одна партиция/очередь (Kafka hash key; NATS subject per key; RabbitMQ consistent-hash exchange) | параллелизм ограничен ключами; добавление партиций ломает маппинг (3.2) |
| Per-partition | свойство партиции Kafka/JetStream | приходит «бесплатно», но только внутри партиции |
| Глобальный | одна партиция / один воркер / специальный секвенсор | параллелизм = 1; throughput одной партиции |
Практическое правило: почти любой «нам нужен глобальный порядок» на ревью превращается в «нам нужен порядок по account_id». Сначала спросите «порядок чего и для кого», потом выбирайте ключ.
Порядок, который ломают сами же
Классические самострелы:
- Retry в отдельный топик/очередь. Событие A не обработалось, уехало
в retry, событие B того же ключа обработалось раньше A. Порядок по
ключу нарушен вашей же ретрай-инфраструктурой. Лечение: вместе с
событием несите версию/номер, консьюмер отбрасывает устаревшие
(
WHERE version < $expected, как в 3.7), или буферизуйте retry по ключу. - Параллельная обработка без учёта ключа. Worker pool, который берёт сообщения из одной партиции в N горутин, уничтожает порядок. Правильно: шардировать по ключу внутри консьюмера (ключ → конкретная горутина, Модуль 9).
- Несколько продюсеров на одну сущность без координации. Два инстанса API пишут события одного заказа — порядок записи в лог undefined. Лечится outbox'ом с версией агрегата.
📖 2.2. Backpressure и flow control
Сценарий: продюсер даёт 50k msg/s, консьюмеры переваривают 10k. Что происходит и что делать:
textinbox: [████████████████████████░░░░░░] lag растёт
           память/диск брокера тают
Механизмы по слоям:
- Клиентский pull/prefetch (RabbitMQ Qos, JetStream MaxAckPending, Kafka fetch sizing) — консьюмер берёт столько, сколько может. База.
- Отказ на входе: очередь с лимитом (
x-max-length+ overflow=reject-publish, Kafka quotas) — продюсер получает backpressure-ошибку и решает: замедлиться, сбросить, буферизовать у себя. - Замедление источника: circuit breaker на продюсере, rate limiter, локальный bounded-канал в Go — публикация блокируется, HTTP-ручка отвечает 429.
go// bounded-очередь публикации: естественный backpressure через блокировку
publishCh := make(chan kafka.Message, 1000) // не безлимитный!

func (p *P) Publish(ctx context.Context, m kafka.Message) error {
	select {
	case publishCh <- m: // ок: место есть
		return nil
	case <-ctx.Done():
		return ctx.Err() // очередь полна и дедлайн истёк — честный отказ
	}
}
Антипаттерн: безлимитная очередь где угодно (канал, list в памяти, сама брокерная очередь без лимитов). Раздувание очереди — не решение проблемы медленного консьюмера, а её откладывание с процентами (курс OrderFlow — как понять, куда уперлись).
📖 2.3. Poison pill, retry-стратегии, circuit breaker
Poison pill
Poison pill — сообщение, которое валит обработчик: битый payload, непредвиденный кейс, баг. Без защиты оно:
- в RabbitMQ с requeue=true — крутится бесконечно (2.3),
- в Kafka может дойти до блокировки партиции (все retry впустую, lag растёт).
Минимальный протокол выживания:
- Декодирование — в отдельной «безопасной» зоне: не смог декодировать — сразу в DLQ, не ретраить.
- Бизнес-ошибки → ограниченные ретраи с backoff → DLQ.
- DLQ — не мусорка, а мониторимая очередь с алертом и процедурой разбора.
Retry: экспоненциальный backoff + jitter
gofunc backoff(attempt int) time.Duration {
	base := 100 * time.Millisecond
	max := 30 * time.Second
	d := base << attempt // 100ms, 200ms, 400ms, ...
	if d > max {
		d = max
	}
	// jitter: ±20% разброс — против «стада», ретраящего синхронно
	jitter := time.Duration(rand.Int63n(int64(d) / 5))
	if rand.Intn(2) == 0 {
		return d + jitter
	}
	return d - jitter
}
Зачем jitter: тысяча воркеров, у которых упал общий upstream, ретраят через ровно 100 мс — вторая волна совпадает до миллисекунды и роняет upstream снова. Разброс размазывает ретраи по времени.
Circuit breaker на консьюмере
Когда обработка зовёт внешний сервис (payment-gateway), и он лежит, ретраи только жгут очередь. Breaker отслеживает долю отказов:
gotype Breaker struct {
	mu        sync.Mutex
	failures  int
	threshold int           // сколько отказов подряд до размыкания
	openedAt  time.Time
	cooldown  time.Duration
}

func (b *Breaker) Allow() bool {
	b.mu.Lock()
	defer b.mu.Unlock()
	if b.failures < b.threshold {
		return true
	}
	return time.Since(b.openedAt) > b.cooldown // half-open: пробуем одну
}

func (b *Breaker) Record(ok bool) {
	b.mu.Lock()
	defer b.mu.Unlock()
	if ok {
		b.failures = 0
		return
	}
	b.failures++
	if b.failures == b.threshold {
		b.openedAt = time.Now()
	}
}
Политикапри разомкнутом breaker'е — осознанная: либо nack/requeue с задержкой (RabbitMQ retry-таймеры из 2.4), либо пауза фетча (Kafka), либо переезд сообщений в «больницу». Важно: breaker защищает upstream, не брокера.
📖 2.4. Outbox pattern: атомарность «БД + публикация»
Проблема
gotx.Commit()           // заказ сохранён
broker.Publish(event) // упало: сеть, рестарт, OOM
// БД говорит «заказ создан», все остальные — не знают. Вечная распря.
Обратный порядок (publish → commit) не лучше: опубликовали, commit упал — мир получил событие о том, чего нет.
Решение
Пишем событие в ту же транзакцию, что и бизнес-данные; отдельный процесс рассылает outbox наружу:
sqlCREATE TABLE outbox (
  id           BIGSERIAL PRIMARY KEY,
  aggregate_id TEXT NOT NULL,
  type         TEXT NOT NULL,
  payload      JSONB NOT NULL,
  created_at   TIMESTAMPTZ NOT NULL DEFAULT now()
);
gofunc (s *Store) CreateOrder(ctx context.Context, o Order) error {
	tx, err := s.db.Begin(ctx)
	if err != nil {
		return err
	}
	defer tx.Rollback(ctx)

	if _, err := tx.Exec(ctx,
		`INSERT INTO orders (id, amount, status) VALUES ($1, $2, $3)`,
		o.ID, o.Amount, "created"); err != nil {
		return err
	}
	// событие — в той же транзакции: либо оба, либо ничего
	if _, err := tx.Exec(ctx,
		`INSERT INTO outbox (aggregate_id, type, payload) VALUES ($1, $2, $3)`,
		o.ID, "order.created", mustJSON(o)); err != nil {
		return err
	}
	return tx.Commit(ctx)
}
Диспетчер: SELECT ... FOR UPDATE SKIP LOCKED
gorows, err := tx.Exec(ctx, `
	DELETE FROM outbox
	WHERE id IN (
		SELECT id FROM outbox
		ORDER BY id
		FOR UPDATE SKIP LOCKED
		LIMIT 100
	)
	RETURNING id, aggregate_id, type, payload`)
FOR UPDATE SKIP LOCKED позволяет нескольким инстансам диспетчера работать
параллельно без взаимных блокировок. Внимание на гарантии:
- Событие гарантированно выйдет (запись в outbox атомарна с бизнесом).
- Событие может выйти дважды (диспетчер умер после DELETE-пометки, до publish — в зависимости от реализации) → at-least-once наружу → консьюмеры обязаны быть идемпотентными. Без вариантов.
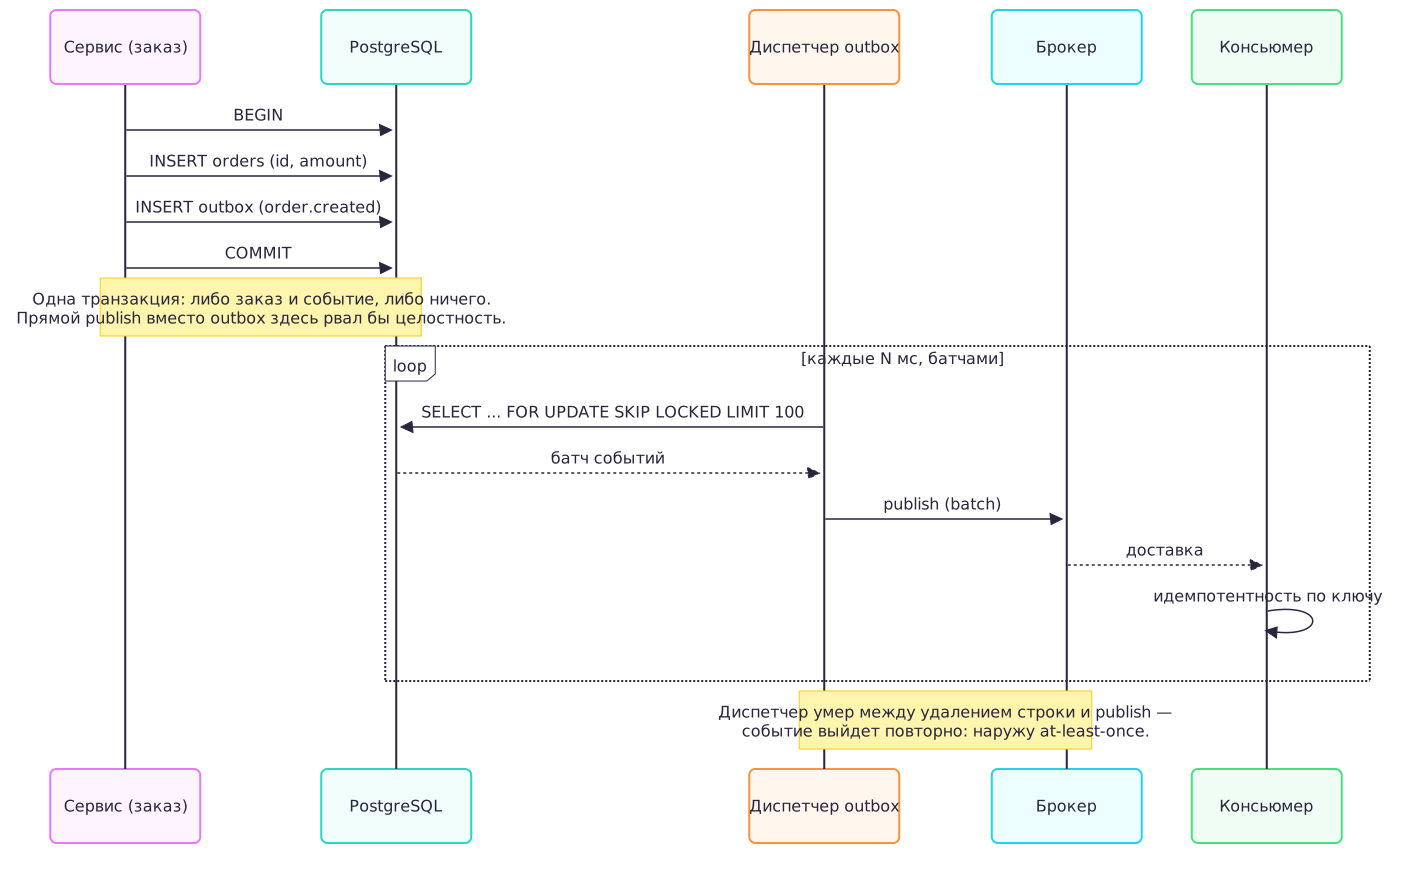
Вариант CDC (Debezium читает WAL) — вместо поллинга; сути гарантий не меняет. Помните связку из 1.2: «seen» и бизнес-данные — одна транзакция. Outbox — та же мысль со стороны продюсера.
💻 Упражнение-ловушка
Outbox растёт: диспетчер лежал 5 минут. При старте он выхлестнет 100k сообщений разом (thundering herd на downstream). Добавьте: rate limit в диспетчере, batch publish, приоритет свежих (или event-sourcing-версии у консьюмеров) — и тест, который роняет диспетчер посреди батча.
📖 2.5. Saga: оркестрация vs хореография
Распределённый процесс «заказ → списать деньги → зарезервировать склад → уведомить» не влезает в одну транзакцию БД. Saga — последовательность локальных транзакций с компенсациями при сбоях.
Хореография
Сервисы сами слушают события и публикуют свои:
textOrder: publish order.created
Payment: слушает → списал → publish payment.completed | payment.failed
Inventory: слушает payment.completed → резерв → publish inventory.reserved
Order: слушает всё → финальный статус
Плюсы: слабая связанность, легко добавлять шаги. Минусы: поток управления размазан по брокеру — «а что сейчас с заказом 42?» — археология по топикам; циклы событий и гонки отлаживать больно.
Оркестрация
Выделенный Saga Orchestrator ведёт состояние и шлёт команды:
gotype SagaState struct {
	OrderID string
	Step    string // payment -> inventory -> notify
}

func (o *Orchestrator) OnEvent(ctx context.Context, ev Event) error {
	switch ev.Type {
	case "payment.completed":
		return o.sendCommand(ctx, "inventory.reserve", ev.OrderID)
	case "inventory.failed":
		// компенсация: вернуть деньги
		return o.sendCommand(ctx, "payment.refund", ev.OrderID)
	case "inventory.reserved":
		return o.complete(ctx, ev.OrderID)
	}
	return nil
}
Плюсы: явная машина состояний, виден прогресс, компенсации тестируемы. Минусы: оркестратор — критичный компонент (state store + HA), риск «супер-сервиса, который всё знает».

Практический выбор: до 3–4 шагов и простые ветвления — хореография; длинные процессы, SLA, ручные шаги — оркестрация. В MVP (курс OrderFlow) будет оркестратор — потому что защита проекта должна показывать состояние процесса, а не раскопки.
📖 2.6. Мониторинг: что алертить
Четыре золотых метрики из Модуля 1 — теперь в коде:
goimport (
	"github.com/prometheus/client_golang/prometheus"
	"github.com/prometheus/client_golang/prometheus/promauto"
)

var (
	msgProcessed = promauto.NewCounterVec(prometheus.CounterOpts{
		Name: "consumer_messages_processed_total",
	}, []string{"topic", "status"}) // status: ok|retry|dead

	processingDuration = promauto.NewHistogramVec(prometheus.HistogramOpts{
		Name:    "consumer_processing_duration_seconds",
		Buckets: prometheus.ExponentialBuckets(0.001, 2, 12), // 1ms .. ~4s
	}, []string{"topic"})

	consumerLag = promauto.NewGaugeVec(prometheus.GaugeOpts{
		Name: "consumer_lag_messages",
	}, []string{"topic", "partition"})
)

func Handle(msg Message) error {
	timer := prometheus.NewTimer(processingDuration.WithLabelValues(msg.Topic))
	defer timer.ObserveDuration()

	if err := process(msg); err != nil {
		msgProcessed.WithLabelValues(msg.Topic, "retry").Inc()
		return err
	}
	msgProcessed.WithLabelValues(msg.Topic, "ok").Inc()
	return nil
}
Что алертить (порог — вопрос SLO, канал — PagerDuty/мессенджер):
| Метрика | Источник | Красная зона |
|---|---|---|
| Consumer lag | брокер (kafka-exporter, rabbitmqctl, JS-статус) | растёт N минут подряд |
| DLQ rate | счётчик dead | > 0.1% за 5 мин |
| Processing duration p99 | гистограмма | выше SLO обработки |
| In-flight / unacked | брокер | упирается в prefetch × воркеры |
| Publish failures + confirm latency | продюсер | любой рост |
Lag без контекста — половина правды: lag 10k при потоке 50k/s — это миллисекунды отставания; lag 10k при потоке 5/s — инцидент. Алертить стоит на тренд lag и на возраст самого старого необработанного сообщения.
📖 2.7. Graceful shutdown: signal.NotifyContext + drain
Задача: при SIGTERM (k8s присылает его всегда) — перестать принимать новые сообщения, доработать in-flight, закоммитить, выйти. Иначе k8s убьёт процесс посреди обработки → дубли после рестарта.
gopackage main

import (
	"context"
	"log"
	"os/signal"
	"sync"
	"syscall"
	"time"
)

func main() {
	ctx, stop := signal.NotifyContext(context.Background(), syscall.SIGINT, syscall.SIGTERM)
	defer stop()

	var wg sync.WaitGroup
	// deliveries — канал сообщений от клиента конкретного брокера,
	// ack/nack/handle — обёртки над ним (см. модули 2-4)
	for i := 0; i < 8; i++ { // worker pool (параллелизм — курс OrderFlow)
		wg.Add(1)
		go func() {
			defer wg.Done()
			for {
				select {
				case <-ctx.Done():
					return
				case msg, ok := <-deliveries:
					if !ok {
						return
					}
					// в handler ctx НЕ прокидываем до конца:
					// начатую работу дорабатываем, ctx обрывает только взятие нового
					if err := handle(context.WithoutCancel(ctx), msg); err != nil {
						nack(msg)
						continue
					}
					ack(msg)
				}
			}
		}()
	}

	<-ctx.Done() // SIGTERM/SIGINT
	log.Print("shutting down: draining in-flight")
	done := make(chan struct{})
	go func() { wg.Wait(); close(done) }()

	select {
	case <-done:
		log.Print("clean exit")
	case <-time.After(25 * time.Second):
		log.Print("shutdown timeout: k8s will SIGKILL; in-flight will be redelivered")
	}
	// здесь же: закрыть консьюмера, соединение с брокером, затем пул БД
}
Три тонкости, которые отличают «работает» от «работает правильно»:
context.WithoutCancel(Go 1.21+) для начатой обработки: бизнес-операция не должна обрываться на середине из-за сигнала — она должна доделаться и закоммититься.- Timeout меньше, чем grace period k8s (
terminationGracePeriodSeconds): если ваш drain 25 сек, а k8s убивает через 30 — успеваете. Наоборот — обидный SIGKILL. - Порядок закрытия ресурсов: сначала перестаём фетчить (Cancel/Close консьюмера), потом drain, потом закрываем connection, потом БД. Обратный порядок теряет сообщения.
💻 Практика
lesson6_1: сломайте порядок параллельным пулом и почините шардированием по ключу — тест на инвариант порядка по account_id.lesson6_3: poison-тест: скормите битый JSON — сервис должен продолжать жить, сообщение уйти в DLQ, алерт-метрика подскочить.lesson6_4: outbox сSKIP LOCKED+ тест «два диспетчера, ноль дублей, ноль потерь» (проверка через idempotency-ключ у консьюмера).lesson6_6: docker-compose с Prometheus+Grafana, дашборд из 4 золотых метрик, искусственный lag — алерт срабатывает.lesson6_7: тест graceful shutdown: SIGTERM посреди батча — инвариант «ноль потерь, дубли допустимы».
🧩 Quiz "Проверь себя"
✅ Итоги модуля
После прохождения ты должен уметь:
- Выбрать уровень порядка (per-key/partition/global) и назвать цену, включая самострелы с retry и параллельными пулами.
- Построить backpressure на трёх слоях: prefetch, лимиты очередей, замедление источника — и объяснить, почему безлимитная очередь — откладывание проблемы.
- Защитить сервис от poison pill и спроектировать DLQ как процесс, а не помойку.
- Реализовать Outbox: атомарная запись события с бизнес-данными, диспетчер на SKIP LOCKED, честные гарантии at-least-once.
- Выбрать между Saga-хореографией и оркестрацией и обосновать выбор.
- Собрать 4 золотые метрики в Prometheus и привязать алерты к трендам.
- Остановить Go-сервис без потерь: NotifyContext, drain, порядок закрытия ресурсов, budget под k8s.
Шпаргалка модуля
| Проблема | Паттерн | Гарантия | Цена |
|---|---|---|---|
| Атомарность БД+брокер | Outbox | at-least-once наружу | идемпотентные консьюмеры |
| Распределённый процесс | Saga | компенсации | состояние/HA оркестратора |
| Медленный downstream | backpressure + breaker | отказ вместо лавины | сложность кода |
| Poison pill | DLQ + safe decode | живой сервис | процесс разбора DLQ |
| Потеря при рестарте | graceful shutdown | ноль потерь in-flight | время остановки |
| Слепота | golden metrics | ранние алерты | инфраструктура мониторинга |
🔗 Мостик к Модулю 3
Паттерны — язык проектирования; теперь к нему инструменты. Дальше — Модуль 3: современные альтернативы и облако — Redpanda и Pulsar, облачные очереди SQS/SNS, Watermill как один интерфейс над всеми брокерами. И держите в голове финал трека: собранный MVP — отдельный курс OrderFlow — склеит все паттерны из этого модуля в работающую систему.