Масштабирование и лидерство
Перед началом: Модули 1-9. Инструменты: Yandex Cloud monitoring, auto-scaling. Время: ~4 ч.
Из M9: мы развернули инфраструктуру через Terraform с CI/CD. Теперь — что делать, когда нагрузка вырастет за пределы serverless.
Опциональный модуль — путь роста. Когда serverless-ядро перестаёт справляться или становится дороже VM, часть нагрузки выносят в Managed Kubernetes. Здесь же — load-тестирование, тюнинг Go, бюджетирование и tech-лидерские практики (RFC, архитектурное ревью).
🔥 Зачем это вообще нужно
Чат вырос до 100k пользователей. YDB упирается в лимиты, Functions не успевают холодным стартом, API Gateway отдаёт 503. Вы открываете Cloud Monitoring и видите: RPS ×10 за месяц. Что масштабировать первым? Где узкое место?
📖 Теория
Сигналы к переходу
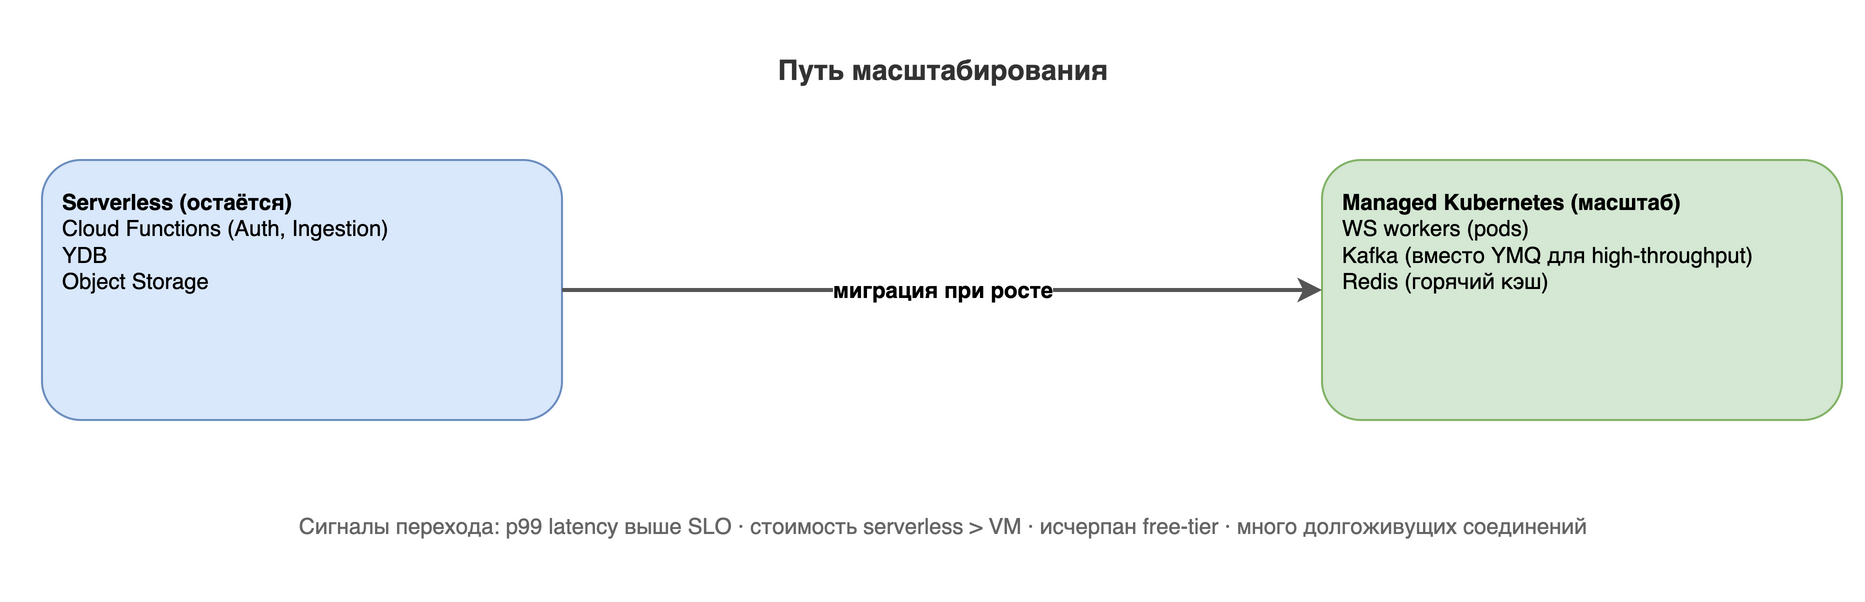
Serverless остаётся ядром (Auth, Ingestion, YDB, Object Storage). В Kubernetes уходят части, требующие контроля над долгоживущими соединениями и высокой пропускной способности: WS-воркеры (pods), Kafka (вместо YMQ для high-throughput), Redis (горячий кэш).
Когда пора: p99 latency выше SLO; стоимость serverless превышает VM; исчерпан free-tier; много долгоживущих WebSocket-соединений с жёсткими требованиями к задержке.
Что уходит в Kubernetes, что остаётся
| Компонент | Решение при масштабе | Почему |
|---|---|---|
| WebSocket-воркеры | K8s pods (Deployment + HPA) | контроль над соединениями, graceful shutdown, оркестрация |
| Очередь high-throughput | Kafka (managed) | replay, партиции, выше пропускная |
| Горячий кэш | Redis (managed) | автокомплит, сессии, rate-limit |
| Auth, Ingestion (CRUD) | остаются в Cloud Functions | stateless, отлично масштабируются |
| YDB, Object Storage | остаются | serverless, не требуют переноса |
Когда делить монолит на микросервисы
Не «сразу», а по границам: когда разные части меняются в разном темпе, требуют разного масштабирования или разных команд. Границы сервисов — по бизнес-возможностям (auth, rooms, messages, notifications), контракты — через явные API (REST/gRPC) с версионированием. Сначала — выделение WS-слоя, затем — разделение по доменам.
Нагрузочное тестирование и тюнинг
k6 — сценарии реальной нагрузки: подключение, отправка сообщения, автокомплит, загрузка медиа. Замеряем p95/p99, CPU, память, GC-паузы.
Тюнинг Go:
GOGC— как быстро растёт куча до GC (по умолчанию 100). Меньше → чаще GC, меньше память, больше CPU.bashGOGC=50 go run ./cmd/server # чаще GC, меньше память, больше CPU GOGC=200 go run ./cmd/server # реже GC, больше память, меньше CPUGOMEMLIMIT— мягкий лимит памяти; ценится в контейнерах с жёстким limit.bashGOMEMLIMIT=4GiB GOGC=100 go run ./cmd/serverpprof— профиль CPU/памяти; не настраивайте GC «вслепую», сначала профиль.bashgo test -cpuprofile cpu.prof -memprofile mem.prof ./... go tool pprof cpu.prof # интерактивный анализ go tool pprof -http=:8080 # веб-интерфейс (flame graph)- Минимизируйте аллокации (переиспользование объектов, буферы вместо конкатенации);
arena— для узких «горячих» участков.
k6 — нагрузочный скрипт (WebSocket-чат):
javascriptimport ws from "k6/ws"
import { check } from "k6"

export const options = {
  stages: [
    { duration: "30s", target: 100 },   // плавный рост до 100 соединений
    { duration: "1m",  target: 100 },   // держим 100
    { duration: "30s", target: 500 },   // поднимаем до 500
    { duration: "1m",  target: 500 },   // держим 500
    { duration: "30s", target: 0 },     // плавно завершаем
  ],
}

export default function () {
  const url = `ws://localhost:8080/ws?token=${__ENV.TOKEN}`
  const res = ws.connect(url, {}, (socket) => {
    socket.on("open",  () => socket.send(JSON.stringify({ type: "message", text: "k6 test" })))
    socket.on("message", (data) => console.log(`recv: ${data}`))
    socket.setTimeout(() => socket.close(), 5000)
  })
  check(res, { "status is 101": (r) => r && r.status === 101 })
}
Docker-ресурсы: явные requests/limits CPU/памяти — чтобы планировщик K8s корректно размещал поды и
HPA работал по метрикам.
Бюджет и планирование
- HPA (Horizontal Pod Autoscaler) — автомасштабирование подов по CPU/RPS или кастомным метрикам.
- Прогноз ресурсов:
RPS × avg_duration— требуемая пропускная способность; закладывайте запас 20–30% под пики (утро/вечер). - Сравнивайте TCO: serverless (оплата за вызовы) vs Reserved instances/K8s (фиксированная стоимость) — при стабильной высокой нагрузке K8s часто дешевле.
Tech-лидерские практики
- RFC — короткий документ на архитектурное решение (контекст, варианты, плюсы/минусы, выбор). Пример для курса: «RFC: переход с Serverless на Kubernetes для чата».
- Архитектурное ревью — проверка решений на соответствие стандартам, рискам, стоимости.
- Защита решений перед бизнесом — цифры (TCO, latency, SLO), а не «мне нравится».
💱 Компромиссы
- Serverless → Managed Kubernetes: контроль над долгоживущими соединениями и пропускной способностью, но операционный overhead (эксплуатация кластера).
GOGCtuning: меньше → чаще GC, ниже память, выше CPU; больше → реже GC, выше память, ниже CPU.- Reserved instances/K8s vs serverless: фиксированная стоимость выгоднее при стабильной нагрузке; serverless — при пиковой/непредсказуемой.
- Монолит → микросервисы: независимое масштабирование и деплой ↔ сложность контрактов и эксплуатации.
Практика
- Написать RFC «Переход с Serverless на Kubernetes для чата»: 1 страница, 3 варианта, TCO, риски.
- Провести нагрузочное тестирование k6 и предложить план масштабирования на 10× рост пользователей.
- Снять профиль pprof горячего сценария и предложить оптимизацию аллокаций.
🔗 К следующему модулю: Система масштабируется. Но как за ней наблюдать?
🧩 Проверь себя
🔗 Мостик к Модулю 11
Система масштабируется. Но как за ней наблюдать? Метрики, логи, трейсы — и всё с trace_id.