Модуль 2. Идемпотентность и Exactly-once Processing
Цель модуля: Научить студента проектировать API, гарантированно выполняющее операцию ровно один раз, даже при сетевых сбоях, ретраях клиента и конкурентных запросах.
Стадия роста проекта: MVP / первые юзеры. Проект пережил стадию идеи, ADR написаны, архитектура выбрана. Появились первые реальные пользователи. Сеть нестабильна, клиенты ретраят, и первое, что ломается — дубли операций. Один платёж — два списания. Один push — два коммита. Одно сообщение — два уведомления.
Перед началом: Модуль 1 (Trade-offs, CAP/PACELC) Инструменты: PostgreSQL, pgx v5, k6, Toxiproxy Трудоёмкость: ~6 ч (теория 1.5 ч · практика 4 ч · ADR 0.5 ч)
🔥 Инцидент: один платёж — два списания
В пятницу вечером нагрузка растёт, сеть «сыпется»: задержки, обрывы соединений. Клиент отправляет POST /api/v1/payments. Транзакция в БД уже зафиксирована — деньги списаны. Но HTTP-ответ ещё не ушёл: сеть рвётся ровно между COMMIT и 200 OK.
Мобильное приложение не получает ответ → считает, что платёж не прошёл → делает ретрай с теми же данными. Сервис видит «новый» запрос → снова запускает бизнес-логику → второе списание. Клиент звонит в поддержку, бухгалтерия в панике.
Дальше — хуже. Из-за багов в UI или параллельных ретраев два воркера одновременно пытаются обработать один запрос. Оба проверяют «уже делали?» — оба видят «нет» — оба списывают. Если проверка не атомарна, гонка неизбежна.
В распределённых системах нестабильность сети — это не исключение, а норма. Нельзя полагаться на «один вызов = одна операция». Ответ — в идемпотентности на уровне бизнес-логики: как гарантировать, что операция выполнится ровно один раз, даже если сеть обрывается, клиент ретраит, а запросы приходят параллельно.
В этом модуле мы разберём, как не допустить двойного списания — от Idempotency-Key до уникального индекса в PostgreSQL и тестов с Toxiproxy.
📖 Теория: Раскрытые термины
Глоссарий модуля:
- Идемпотентность — повторное выполнение операции даёт тот же результат:
f(f(x)) = f(x).SET x=5идемпотентно;x=x+1— нет. - Race Condition (гонка) — несколько параллельных процессов читают/пишут общие данные без синхронизации; результат зависит от порядка выполнения.
- Dual-Write — запись в два разных хранилища (например, БД + кэш/брокер) без общей транзакции: одно может зафиксироваться, а второе — нет.
- Clean Architecture — разделение слоёв
Handler → Use Case → Repository, где бизнес-логика (Use Case) не зависит ни от фреймворка, ни от БД. - Nonce — одноразовое случайное значение, защищающее от повтора запроса (replay).
- At-least-once Delivery — сеть всегда доставляет дубликаты: брокеры и retry не гарантируют однократную доставку.
- Exactly-once Processing — «ровно один раз» достигается НЕ сетью, а идемпотентностью на стороне обработки.
- 23505 Unique Violation — код ошибки PostgreSQL при нарушении уникального индекса; перехватывать явно, не как «любое исключение».
2.1. At-least-once Delivery vs Exactly-once Processing
At-least-once Delivery (Доставка минимум один раз): Сеть, балансировщики и брокеры сообщений (Kafka/RabbitMQ) всегда стремятся доставить сообщение. Если они не получили подтверждения (ACK), они отправят его снова. Это значит, ваш сервис всегда будет получать дубликаты запросов.
Exactly-once Processing (Обработка ровно один раз): Этого невозможно достичь на уровне сети. Это достигается на уровне бизнес-логики через Идемпотентность. Если сервис получил тот же запрос дважды, он должен выполнить бизнес-операцию один раз, а на второй запрос вернуть результат первой операции.
2.2. Ключ идемпотентности (Idempotency-Key)
Механизм, популяризированный Stripe. Клиент генерирует уникальный UUID для конкретной бизнес-операции и отправляет его в заголовке Idempotency-Key.
Если сервер видит ключ впервые — он выполняет операцию и сохраняет результат.
Если сервер видит ключ повторно — он возвращает сохраненный результат без выполнения логики.
2.3. Антипаттерн: Redis как источник истины
Redis можно использовать только как кэш для быстрого возврата результата, но не как источник истины для проверки существования ключа. Проверка «ключ уже есть» должна быть атомарной и происходить в той же транзакции БД, что и бизнес-операция. Иначе возникает гонка: два воркера одновременно видят «ключа нет», оба начинают обработку, и происходит двойное списание.
2.4. Защита от Replay-атак и сценарий "потерянного 200 OK"
Идемпотентность защищает не только от сбоев сети на сервере, но и от сценария, когда транзакция прошла успешно, но сеть оборвалась до отправки HTTP-ответа клиенту. Клиент делает ретрай с тем же ключом, и сервер должен вернуть тот же payment_id и статус, как будто ничего не изменилось. Для защиты от злоумышленников используется Nonce + Timestamp + HMAC (сервер отклоняет запросы старше 5 минут).
2.5. Этот паттерн в архетипах
Идемпотентность проявляется по-разному в четырёх архетипах проектов:
| Архетип | Механизм идемпотентности | Ключ | Почему критично |
|---|---|---|---|
| Финтех (P2P) | Idempotency-Key + UNIQUE index | UUID клиента | Двойное списание = деньги потеряны |
| Git-хостинг | Оптимистичная блокировка по SHA: before должен совпадать с текущим HEAD | SHA коммита (детерминированный) | Push с тем же SHA = no-op; push с устаревшим before = reject |
| Мессенджер | Дедупликация по message_id | UUID сообщения | Дубль = спам в чате |
| Лента / чтение | Идемпотентная публикация поста | UUID поста | Дубль = мусор в ленте |
Общий принцип: каждая бизнес-операция должна иметь уникальный ключ, по которому сервер отличает ретрай от нового запроса. Различается только источник ключа: клиент генерирует (финтех, мессенджер), или ключ детерминирован из данных (Git SHA).
2.6. Компромиссы (Trade-offs)
| Подход | Плюс | Минус | Когда выбирать |
|---|---|---|---|
| Redis как источник истины | быстрый путь (O(1) GET) | гонка: check и write — разные транзакции; дубль при конкурентных запросах | нельзя для критичных операций (платежи) |
| DB unique index | атомарная проверка в одной транзакции (INSERT → 23505) | каждый INSERT занимает БД-ресурс | критичные операции (деньги) |
| Nonce + HMAC | полная защита от replay-атак | ограничение window (±2 мин) + сложность реализации | публичные API с платёжами |
| Только Idempotency-Key (без HMAC) | простой ключ спасает от случайных дублей | не защищает от перехвата/повтора злоумышленником | внутренние API между доверенными сервисами |
Вывод для курса: для финтеха — DB unique index + HMAC; для внутренних вызовов — Idempotency-Key достаточно. См. ADR-2.
🛠 Практические задания
Сценарий: API приема платежа POST /api/v1/payments. Клиент отправляет сумму и ID получателя. Из-за нестабильной сети клиент может отправить этот запрос несколько раз параллельно или с задержкой.
Примерный план работы:
- Спроектировать таблицу
idempotency_keys→ проверить схему (unique index, TTL). - Реализовать UseCase
WithdrawIdempotent→ persist(платёж) + persist(ключ) в одной транзакции. - Обработать
23505→ SELECT + возврат существующего результата. - Протестировать через Toxiproxy + k6 → SLO: 10 параллельных, 1 списание, 10 ответов 200.
- Написать ADR-2: «Redis vs DB unique index».
Задача 1: Проектирование БД и Clean Architecture
Студенту необходимо спроектировать таблицу idempotency_keys и реализовать логику в рамках Clean Architecture (Handler → Use Case → Repository).
Требования к таблице idempotency_keys:
- Поля:
key(UUID),payment_id(FK),status,created_at. - Важно: Не хранить полный JSON-ответ. Ответ формируется заново по
payment_id. - Уникальный индекс по
key. - TTL-политика: ключи старше 30 дней удаляются (через
pg_cronили job). Индекс поcreated_atдля эффективного удаления.
Логика слоев:
- Handler: Проверяет наличие ключа в БД (через Repository). Если найден — сразу возвращает результат.
- Use Case: Принимает флаг
is_idempotentиidempotency_key. Если результат уже есть, возвращает его без запуска бизнес-логики.
✅ Готово, когда:
- Таблица
idempotency_keys:key UUID UNIQUE,payment_id FK,status,created_at+ индекс поcreated_atдля TTL-удаления - Полный JSON-ответ не хранится — результат формируется по
payment_id - Слои Clean Architecture: Handler → UseCase → Repository; Handler проверяет ключ и возвращает результат без вызова бизнес-логики
- ADR-2 «Redis vs DB unique index» написан
Задача 2: Защита от Race Condition (Конкурентных запросов)
Клиент отправил два одинаковых запроса одновременно. Оба воркера не нашли ключ в БД и начали выполнять транзакцию.
Решение: Уникальный индекс в PostgreSQL. Первый воркер успешно вставляет строку. Второй получает ошибку 23505 Unique Violation. Код должен явно перехватывать именно эту ошибку, делать SELECT по ключу и возвращать существующий результат.
go// Go: ключ и платёж — в одной транзакции, атомарный захват ключа
func (h *PaymentHandler) Pay(w http.ResponseWriter, r *http.Request) {
    key := r.Header.Get("Idempotency-Key")

    tx, err := h.db.BeginTx(r.Context(), pgx.TxOptions{})
    if err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }
    defer tx.Rollback(r.Context()) // no-op после Commit

    // Атомарно захватываем ключ; 0 затронутых строк = уже было обработано
    tag, err := tx.Exec(r.Context(),
        `INSERT INTO idempotency_keys (key) VALUES ($1)
         ON CONFLICT (key) DO NOTHING`, key)
    if err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }
    if tag.RowsAffected() == 0 {
        // Конкурент успел первым — возвращаем его результат
        tx.Rollback(r.Context())
        respondByKey(w, h.repo.FindByKey(r.Context(), key))
        return
    }

    var paymentID string
    err = tx.QueryRow(r.Context(),
        "INSERT INTO payments (...) VALUES (...) RETURNING id").Scan(&paymentID)
    if err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }

    if err := tx.Commit(r.Context()); err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }
    writeJSON(w, map[string]string{"payment_id": paymentID})
}
✅ Готово, когда:
- Используется
INSERT ... ON CONFLICT DO NOTHING(pgx) - При ошибке
23505код делаетSELECTпо ключу и возвращает уже существующий результат - Ошибка
23505не протекает наружу как HTTP 500 — клиент получает корректный200 OK
Задача 3: Тестирование через Toxiproxy и k6
Настроить Toxiproxy на пути между клиентом и API, добавив задержку и обрыв 50% соединений. Это заставит клиент k6 делать ретраи.
В скрипте k6 жестко задать один Idempotency-Key для 10 параллельных запросов.
Цель (SLO): В БД должна появиться ровно 1 операция списания. 10 запросов должны получить HTTP 200 OK с одинаковым payment_id.
✅ Готово, когда:
- Toxiproxy на пути клиент → API: задержка + обрыв 50% соединений (клиент k6 делает ретраи)
- Один
Idempotency-Keyдля 10 параллельных запросов - В БД — ровно 1 списание
- Все 10 ответов —
200 OKс одинаковымpayment_id
⚠️ Антипаттерн для разбора
Студенту даётся код — нужно найти уязвимость (Dual-Write).
go// Go HTTP-хендлер (Антипаттерн)
func (h *PaymentHandler) Pay(w http.ResponseWriter, r *http.Request) {
    key := r.Header.Get("Idempotency-Key")
    // 1. Проверяем в Redis
    if v, ok := h.cache.Get(r.Context(), key); ok {
        writeJSON(w, v)
        return
    }
    // 2. Выполняем платёж
    payment, err := h.svc.Withdraw(r.Context(), amountFrom(r))
    if err != nil {
        http.Error(w, err.Error(), http.StatusInternalServerError)
        return
    }
    // 3. Сохраняем в БД
    if _, err := h.db.Exec(r.Context(), "INSERT INTO payments (...) VALUES (...)", payment.ID); err != nil {
        http.Error(w, err.Error(), http.StatusInternalServerError)
        return
    }
    // 4. Кладём ключ в Redis на 24 часа
    h.cache.Set(r.Context(), key, payment.ID, 24*time.Hour)
    writeJSON(w, payment)
}
Ошибка: Dual-Write (Redis + БД). При конкурентных запросах оба пройдут проверку cache.Get (вернёт «нет»), оба спишут деньги, и только потом второй запишет ключ. Результат: двойное списание. Проверка в Redis не атомарна с записью платежа.
✅ Правильное решение
Идемпотентность проверяется в той же транзакции БД, что и бизнес-данные, через уникальный индекс по key. Конкурентный «проигравший» ловит нарушение уникальности (23505) и возвращает уже созданный результат.
go// Go: ключ и платёж — в одной транзакции, атомарный захват ключа
func (h *PaymentHandler) Pay(w http.ResponseWriter, r *http.Request) {
    key := r.Header.Get("Idempotency-Key")

    tx, err := h.db.BeginTx(r.Context(), pgx.TxOptions{})
    if err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }
    defer tx.Rollback(r.Context()) // no-op после Commit

    // Атомарно захватываем ключ; 0 затронутых строк = уже было обработано
    tag, err := tx.Exec(r.Context(),
        `INSERT INTO idempotency_keys (key) VALUES ($1)
         ON CONFLICT (key) DO NOTHING`, key)
    if err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }
    if tag.RowsAffected() == 0 {
        // Конкурент успел первым — возвращаем его результат
        tx.Rollback(r.Context())
        respondByKey(w, h.repo.FindByKey(r.Context(), key))
        return
    }

    var paymentID string
    err = tx.QueryRow(r.Context(),
        "INSERT INTO payments (...) VALUES (...) RETURNING id").Scan(&paymentID)
    if err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }

    if err := tx.Commit(r.Context()); err != nil {
        http.Error(w, "internal error", http.StatusInternalServerError)
        return
    }
    writeJSON(w, map[string]string{"payment_id": paymentID})
}
📐 Задание по визуализации (Mermaid)
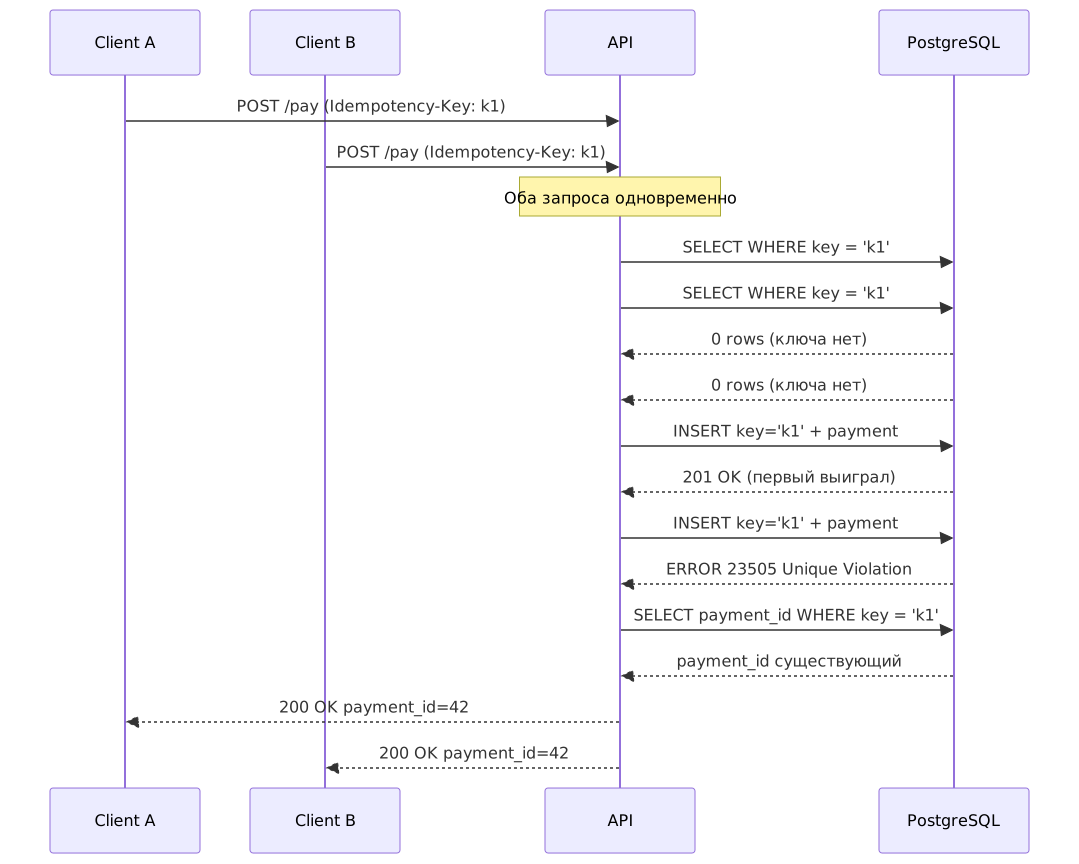
Студенту необходимо нарисовать Sequence Diagram, показывающий гонку двух воркеров и обработку ошибки БД.
Обязательные элементы:
- Два параллельных запроса от клиента (один Idempotency-Key).
- Оба воркера начинают транзакцию (BEGIN).
- Первый воркер делает
INSERT INTO idempotency_keys. - Второй воркер пытается сделать тот же INSERT → получает ошибку
23505 Unique Violation. - Второй воркер ловит именно эту ошибку, делает
SELECTпо ключу, возвращает сохраненныйpayment_id. - Клиент получает два 200 OK с одинаковым
payment_id.
Шаблон для ориентира:
🧩 Проверь себя
🤖 Инструкция для LLM (Coding Plan Assistant) — Режим Модуля 2
Привет! Я начинаю Модуль 2 курса «Архитектура распределённых систем».
Дай короткий ответ (2–3 предложения): почему проверки
Idempotency-Keyчерез Redis недостаточно, и почему это обязательно нужно делать через реляционную БД с уникальным индексом?Предоставь мне требования к таблице
idempotency_keys: поля, индексы, TTL-политика.Покажи мне код Антипаттерна (с Redis) и попроси меня объяснить, где именно произойдёт двойное списание при конкурентных запросах и почему проверка в Redis не спасает.
Дай описание API приёма платежа: URL, заголовки, параметры, ожидаемые ответы.
НЕ ПИШИ за меня реализацию Middleware, Use Case и логику БД. Дождись моего ответа. После этого дай фидбек по чек-листу ментора и укажи на слепые зоны (например, «ты не учёл случай, когда клиент не получил 200», «нет обработки именно 23505», «логика не встроена в Use Case»).
📝 Чек-лист ментора
-
Студент чётко разделяет At-least-once Delivery и Exactly-once Processing.
-
В таблице
idempotency_keysесть уникальный индекс поkey, и он используется как источник истины. -
Ошибка
23505обрабатывается явно, а не как «любое исключение». -
Запись ключа и бизнес-операции происходят в одной транзакции.
-
Результат не хранится как JSON-ответ, а как
payment_id+status. -
Есть TTL-политика и план очистки старых ключей.
-
Идемпотентность реализована не только в инфраструктуре (Middleware), но и в бизнес-слое (Use Case).
-
Тест k6 + Toxiproxy реально показывает: 10 запросов → 1 списание → 10 ответов 200 с одинаковым
payment_id. -
Mermaid-диаграмма корректно показывает гонку и обработку Unique Violation.
-
Студент понимает сценарий «транзакция прошла, клиент не получил 200, ретраит» и как система на это реагирует.
-
Студент понимает, как идемпотентность проявляется в разных архетипах (финтех, Git, мессенджер, лента).
-
ADR-2: Student сформулировал ADR «Redis vs DB unique index» (контекст, альтернативы, решение, последствия).
🔗 Мостик к Модулю 3 (Outbox)
В конце ревью обязательно скажи студенту:
- «Отлично, мы добились того, что платеж не задвоится. Но что если после успешного списания нам нужно отправить событие в Kafka (например, для уведомления пользователя)? Если мы просто пошлём HTTP/Kafka-запрос после коммита БД, и сеть упадёт — событие потеряется. В Модуле 3 мы решим проблему Dual-Write (БД + Брокер) с помощью паттерна Transactional Outbox, чтобы гарантировать доставку событий без потери согласованности.»
Если ты прошёл курс «Git Hosting: Serverless MVP», ты уже видел этот паттерн на упрощённом стеке: YDB Serverless с атомарным UPDATE вместо PostgreSQL с FOR UPDATE, Message Queue вместо Kafka. Паттерн тот же — инфраструктура разная. Здесь мы разбираем его на полном стеке, с глубиной и trade-offs.