Модуль 6. Observability и SLO: наблюдаемость и целевые уровни сервиса
Цель модуля: Сделать распределённую систему полностью прозрачной для эксплуатации. Научить студента связывать логи, метрики и трейсы (Three Pillars) через OpenTelemetry. Спроектировать SLO (Service Level Objectives) и настроить алертинг на основе деградации бизнеса. Инфраструктура: Open Source стек (Prometheus, Jaeger, Loki) на Yandex Cloud.
Стадия роста проекта: Продакшен 24/7. Проект пережил интеграции, Outbox, Saga и Resilience. Система работает круглосуточно, метрики прозрачны, секреты в Lockbox. Но пришло время доказать, что система действительно надёжна — и первое, что ломается — видимость. Инциденты расследуются часами вместо минут, потому что логи, метрики и трейсы не связаны.
Перед началом: Модули 1–5 (особенно Resilience — метрики CB, Outbox — trace_id) Инструменты: OpenTelemetry, Prometheus, Jaeger, Loki, Alertmanager Трудоёмкость: ~6 ч (теория 1.5 ч · практика 4 ч · ADR 0.5 ч)
🔥 Инцидент: тишина, которая страшнее ошибок
Circuit Breaker, Bulkhead и кэш работают (Модуль 5). В Grafana всё «зелёное»: RPS стабильный, latency в норме, HTTP-ошибок почти нет. Но в понедельник — письмо от дежурного: «Клиенты жалуются, что переводы зависают. В логах тишина: одни INFO. А количество компенсаций в Saga за выходные превысило сотню, и никто не понимает, на каком шаге и почему».
Ты начинаешь копать. Логи есть, но без связи: в одном сервисе «KYC skipped», в другом «Compensation triggered» — и ни одного общего идентификатора. Метрики: error rate почти нулевой — потому что компенсации это не HTTP 500, а бизнес-решения. На них нет алертов. Трейсы: в Jaeger видны обрывки — трейс есть до Kafka, а дальше пустота. Консьюмер не подхватывает trace_id, и история перевода распадается на несвязанные куски.
И ещё: кто-то в коде логирует email и номер счёта «для удобства отладки» — утечка PII. А в Prometheus — метка user_id для каждого платежа: количество временных рядов взлетело, мониторинг начинает тормозить от взрыва кардинальности.
Три вопроса, на которые нужно ответить:
- «Что пошло не так?» — сквозные трейсы с
trace_idчерез Kafka (доработать Outbox: хранить trace_id в колонке, копировать в Kafka headers). - «Насколько всё плохо для бизнеса?» — правильные метрики: не «сколько HTTP 500», а «сколько компенсаций / 10 мин», «CB в Open > 1 мин», «сожжено > 80% Error Budget».
- «Где причина в логах?» — структурированные JSON-логи с
trace_id,span_id,error_class— и без PII.
Невидимая система неуправляема. Observability — это не «собирать логи», а связать трейсы, метрики и логи в единую картину, где инцидент расследуется за минуты, а не часы.
📖 Теория: Раскрытые термины
Глоссарий модуля:
- Span / Trace — Span: одна операция в трейсе; Trace: дерево Span-ов сквозь сервисы, склеенное общим
trace_id. - Time series (временной ряд) — последовательность значений метрики во времени; каждая уникальная комбинация labels = отдельный ряд.
- Cardinality (кардинальность) — число различных значений метки;
user_idдаёт «взрыв» рядов и OOM Prometheus. - PII (Personally Identifiable Information) — персональные данные (email, телефон, номер карты); логировать нельзя — только маской.
- Scrape — сбор метрик Prometheus-ом с endpointа
/metricsпо расписанию. - SLI / SLO / SLA — SLI: метрика; SLO: целевое значение; SLA: внешний договор с клиентом.
- Error Budget — 100% минус SLO = допустимый «запас ошибок»; алерты при сжигании >80% за окно.
- OpenTelemetry — единый стандарт трейсинга/метрик/логов: SDK + collector, кросс-языковой, пробрасывает trace_id от API до воркера через Kafka headers.
6.1. Три кита Observability
Logs (Логи): Дискретные события. Должны быть структурированными (JSON) и содержать trace_id, span_id, tenant_id и error_class (для быстрого поиска в Loki).
Metrics (Метрики): Агрегированные данные во времени (RPS, latency, error rate). Отлично подходят для алертинга (Prometheus).
Traces (Трейсы): Дерево вызовов (Span) сквозь все микросервисы. Показывают, где именно система тратит время или упала (Jaeger).
6.2. Span, Trace и Jaeger: как читать трейсы
Span — единичная операция: HTTP-запрос, вызов БД, отправка в Kafka. У каждого Span-а есть:
trace_id— общий для всего дерева (один перевод = одинtrace_id).span_id— уникальный для каждого Span-а.parent_span_id— ссылка на родительский Span (образует дерево).- duration — сколько времени заняла операция.
- attributes — метаданные:
db.statement,http.url,messaging.destination.
Trace — дерево Span-ов сквозной через все сервисы. Пример перевода:
[API] POST /transfer                     220ms  ← корневой span
  ├── [Saga] HandleTransfer               190ms
  │     ├── [DB] INSERT payment+outbox      15ms
  │     ├── [Kafka] Publish command          5ms
  │     └── [Worker] ProcessPayment        160ms  ← здесь тормозит!
  │           ├── [DB] SELECT account          8ms
  │           ├── [KYC] CheckKyc            120ms  ← виновник
  │           └── [DB] UPDATE balance         12ms
  └── [Response] 200 OK                     2ms
Jaeger — UI для просмотра трейсов. Показывает «водопад» (waterfall): каждый Span — горизонтальная полоса, длина = duration. Вы сразу видите, какой вызов занял больше всего. В Jaeger вы:
- Ищете по
trace_id(из лога) → видите полный путь запроса. - Находите самый длинный Span → это «узкое место».
- Раскрываете attributes Span-а → видите SQL-запрос или URL.
Без Jaeger отладка распределённой системы = SSH на 5 серверов и grep логов. С Jaeger — один клик.
6.3. Распределённая трассировка и Outbox
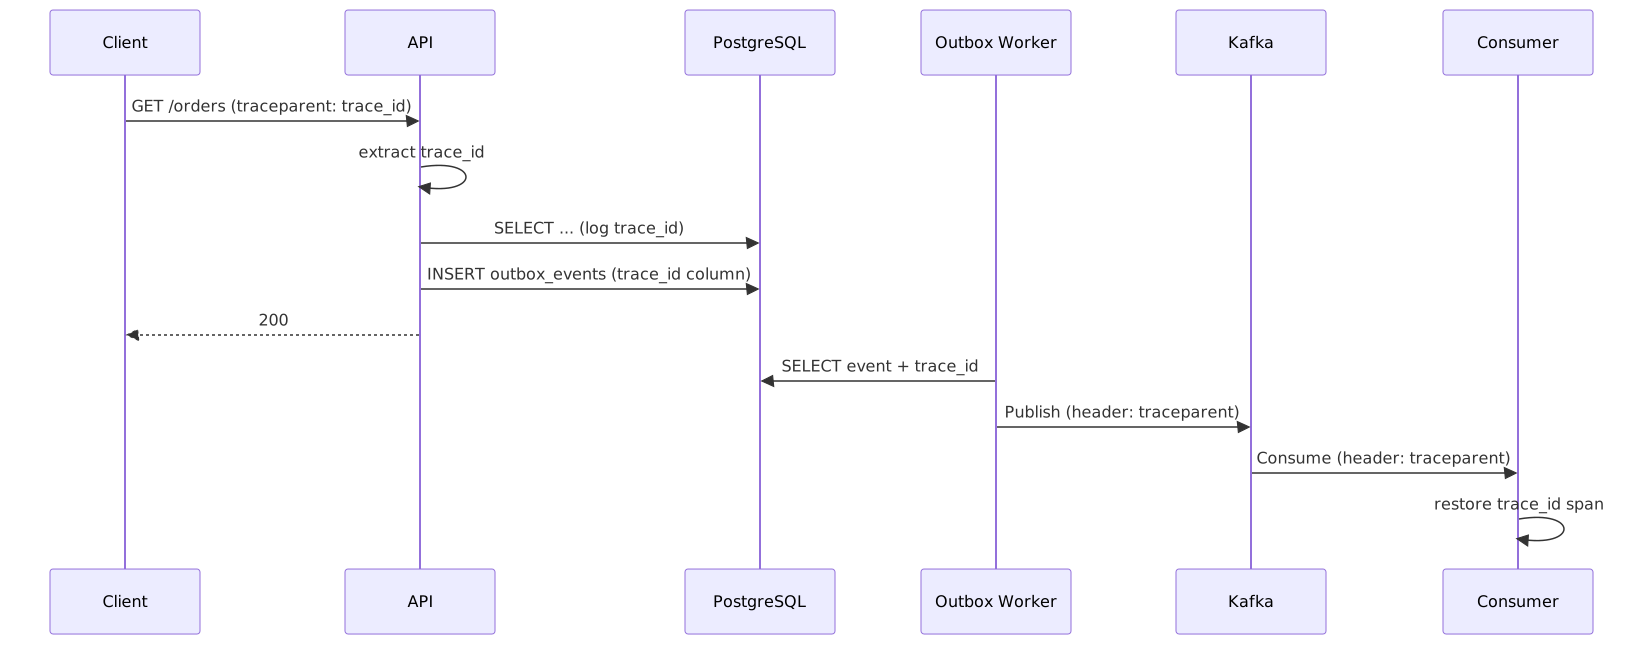
Трейс рождается на Edge (API Gateway) и передается через HTTP-заголовки (traceparent). Критично: При прохождении через Kafka трейс обрывается. Чтобы этого избежать, trace_id должен сохраняться в отдельной колонке таблицы outbox_events (не внутри JSON payload), а воркер Outbox должен явно копировать его в заголовки Kafka-сообщения. Консьюмер на той стороне восстанавливает контекст из заголовков.
go// В Outbox-воркере: trace_id из колонки → Kafka headers
func (w *OutboxWorker) publish(ctx context.Context, ev OutboxEvent) error {
    msg := &kafka.Message{
        Topic: "payment.events",
        Key:   []byte(ev.AggregateID),
        Value: ev.Payload,
        Headers: []kafka.Header{
            {Key: "traceparent", Value: []byte(ev.TraceID)}, // сквозной трейс
        },
    }
    return w.producer.WriteMessages(ctx, msg)
}

// В консьюмере: восстанавливаем контекст из headers
func (c *Consumer) handle(ctx context.Context, msg kafka.Message) error {
    traceparent := extractHeader(msg.Headers, "traceparent")
    ctx = otel.GetTextMapPropagator().Extract(ctx, propagation.HeaderCarrier{
        "traceparent": []string{traceparent},
    })
    ctx, span := otel.Tracer("payment-worker").Start(ctx, "ProcessPayment")
    defer span.End()
    // ... бизнес-логика
}
6.4. Взрыв кардинальности (Cardinality Explosion)
Архитектор не должен класть в метки Prometheus user_id, order_id или email. Каждая новая комбинация лейблов создает новую временную серию (time series). 1 миллион пользователей = 1 миллион серий = OOM-kill Prometheus.
Правило: Лейблы — только для статусов (HTTP status, error_type, service).
go// Только статусы и сервис — низкая кардинальность
var paymentsTotal = promauto.NewCounterVec(prometheus.CounterOpts{
    Name: "payments_total",
}, []string{"status", "service"})

// в обработчике:
paymentsTotal.WithLabelValues("success", "kyc").Inc()
6.5. SLO и Error Budget
SLI (Indicator): Метрика (например, доля успешных HTTP 200 ответов).
SLO (Objective): Цель (например, 99.9% запросов успешны за скользящее окно 1 час).
Error Budget: Допустимый лимит ошибок (0.1%). Алерты должны срабатывать при сжигании > 80% бюджета за 4 часа, а не при каждой ошибке.
6.6. Этот паттерн в архетипах
Observability проявляется по-разному в четырёх архетипах проектов:
| Архетип | Ключевой трейс | Бизнес-метрика | Почему критично |
|---|---|---|---|
| Финтех (P2P) | Перевод: API → Saga → KYC → БД | saga_compensation_total, circuit_breaker_state | Компенсации — бизнес-решения, не HTTP 500 |
| Git-хостинг | Push: Smart HTTP → Outbox → Webhook | outbox_pending_count, git_semaphore_inuse | Вебхуки теряются тихо, CI не запускается |
| Мессенджер | Сообщение: Send → Deliver → Read | delivery_latency_p99, offline_queue_size | Отправлено, но не доставлено |
| Лента / чтение | Запрос: API → Кэш → БД → CDN | cache_hit_ratio, stale_serve_total | Лавина на БД при протухшем кэше |
Общий принцип: три кита (Logs, Metrics, Traces) + SLO + Error Budget. Различается только бизнес-метрика и критичность инцидента.
6.7. Компромиссы (Trade-offs)
| Подход | Плюс | Минус | Когда выбирать |
|---|---|---|---|
| Auto-instrumentation OTel | минимум кода; все HTTP/DB/span автоматически | overhead на каждый запрос (span creation); меньше контроля | старт, быстрый первый шаг |
| Manual spans (SDK) | точный контроль: создавать span только для значимых операций | больше кода; можно забыть span | оптимизация overhead |
| Логи + метрики без трейсов | проще стек | нет корреляции: «что именно тормозит» | антипаттерн для распределённой системы |
| SLO без Error Budget | дежурные алертят при каждой ошибке | alert-fatigue, инвалидация доверия к алертам | антипаттерн |
Вывод для курса: auto-instrumentation для старта → manual для hotspot; SLO + Error Budget — обязательно. См. ADR-6.
🛠 Практические задания
Примерный план работы:
- Распределённый трейсинг (OpenTelemetry) →
trace_idвoutbox_events, сквозной трейс от API до Worker через Kafka headers. - Метрики Prometheus →
payments_total{status,service},circuit_breaker_state,outbox_pending_count(низкая кардинальность). - Структурированные логи JSON →
level,trace_id,span_id,tenant_id(корреляция с Jaeger). - SLO-алертинг → CB Open > 1 мин, Error Budget > 80% / 4 ч, compensation > 5 / 10 мин.
Задача 1: Распределенная трассировка (OpenTelemetry)
Внедрить сквозной трейсинг от API до БД и Kafka.
Go: В консьюмере Kafka восстановить контекст из заголовков, создать span и закрыть его в defer.
Outbox (Модуль 3): Добавить колонку trace_id в таблицу outbox_events. При поллинге извлекать его и класть в kafka.Message.Headers.
✅ Готово, когда:
- Колонка
trace_idвoutbox_events; при поллинге кладётся в Kafka headers - Консьюмер Kafka восстанавливает контекст трейса из headers
- В Jaeger видно единое дерево трейса от API → Worker → БД → Kafka
- ADR-6 «Auto-instrumentation vs manual» написан
Задача 2: Метрики Prometheus (Связь с Модулями 3-5)
Выставить endpoint /metrics.
Безопасный вариант (низкая кардинальность):
go// Только статусы и сервис — низкая кардинальность
var paymentsTotal = promauto.NewCounterVec(prometheus.CounterOpts{
    Name: "payments_total",
}, []string{"status", "service"})

// в обработчике:
paymentsTotal.WithLabelValues("success", "kyc").Inc()
Собирать метрики: saga_compensation_total{state="failed"}, circuit_breaker_state{service="kyc", state="open"}, outbox_pending_count.
✅ Готово, когда:
- Endpoint
/metricsв формате Prometheus exposition - Низкая кардинальность:
payments_total{status,service}— безuser_idкак label - Бизнес-метрики:
saga_compensation_total,circuit_breaker_state,outbox_pending_count
Задача 3: Структурированные логи (Loki)
Настроить логирование в JSON формате (slog в Go). Обязательная схема:
json{
  "level": "error",
  "span_id": "a1b2c3",
  "trace_id": "x1y2z3",
  "tenant_id": "t123",
  "error_class": "compensation_failure",
  "message": "Compensation failed for saga_id=s123"
}
Go (slog):
go// Структурированный лог с trace_id и error_class
slog.Error("Compensation failed",
    slog.String("trace_id", span.SpanContext().TraceID().String()),
    slog.String("span_id", span.SpanContext().SpanID().String()),
    slog.String("tenant_id", tenantID),
    slog.String("error_class", "compensation_failure"),
    slog.String("saga_id", sagaID),
)
✅ Готово, когда:
- Логи в JSON-формате (
slog) - Обязательные поля:
level,span_id,trace_id,tenant_id,error_class - Лог коррелируется с Jaeger-трейсом через
trace_id+span_id
Задача 4: SLO-Алертинг
Настроить алерт в Alertmanager на бизнес-события:
- "Circuit Breaker находится в Open > 1 минуты".
- "Количество
saga_compensation_totalза последние 10 минут превысило 5". - "Сожжено > 80% Error Budget за 4 часа".
✅ Готово, когда:
- Алерт:
circuit_breaker_state == openдлится > 1 минуты - Алерт:
saga_compensation_totalза 10 минут > 5 - Алерт: сожжено > 80% Error Budget за 4 часа
- Все алерты маршрутизированы в Alertmanager
⚠️ Антипаттерн для разбора
Студенту дается код логирования/метрик для анализа.
go// Go (Антипаттерн)
slog.Info("User made payment",
    slog.String("user_id", user.ID),
    slog.String("email", user.Email), // ❌ Утечка PII
    slog.Float64("amount", amount),
)

// ❌ Метрика с высокой кардинальностью (user_id как label)
paymentsPerUser.WithLabelValues(user.ID).Inc()
Вопросы студенту:
- Чем опасен лог
emailпользователя (помимо GDPR)? - Что произойдет с Prometheus, если эту метрику будут дергать 100 000 разных
user_idв минуту? - Чего не хватает в логе для сквозной отладки (корреляции с Jaeger)?
📐 Задание по визуализации (Mermaid)
Студенту необходимо нарисовать схему передачи trace_id через синхронные HTTP-вызовы и асинхронные (Kafka).
Шаблон для ориентира:
🧩 Проверь себя
🤖 Инструкция для LLM (Coding Plan Assistant) — Режим Модуля 6
Привет! Я начинаю Модуль 6 курса «Архитектура распределённых систем».
Дай короткий ответ (2–3 предложения): почему
trace_idобрывается при прохождении сообщения через Kafka, и как нужно изменить Outbox (из Модуля 3), чтобы трейс восстанавливался на стороне консьюмера?Объясни риск "взрыва кардинальности" в Prometheus. Почему нельзя использовать
user_idилиorder_idв качестве label? Покажи, как правильно группировать метрики.Покажи мне код Антипаттерна (логирование с email и метрика с user_id) и попроси меня объяснить все последствия для Observability.
Дай описание задания: внедрить OpenTelemetry (с пробросом через Kafka), настроить метрики Prometheus для Saga и CB, создать SLO-алерт и структурированные логи с
error_class. Обязательно добавь требование по хранениюtrace_idв Outbox (отдельная колонка) и его переносу в Kafka headers.НЕ ПИШИ за меня реализацию OTel-инструментации. Дождись моего ответа с архитектурным планом. После этого дай фидбек по чек-листу ментора и укажи на слепые зоны (например, «ты теряешь trace_context в Kafka», «метрики протекают», «нет error_class в логах»).
📝 Чек‑лист ментора
-
Логи: Структурированы (JSON). Содержат
trace_id,span_id,tenant_idиerror_class. -
Trace Context Propagation:
trace_idуспешно пробрасывается через HTTP, PostgreSQL и Kafka. В Outbox есть отдельная колонкаtrace_id. -
Go Spans: В Go-консьюмере
trace_contextвосстанавливается из Kafka headers, span создаётся и корректно закрывается вdefer. -
Метрики Prometheus: Нет высокой кардинальности (нет
user_idв labels). Используются толькоstatus,error_type,service. -
Бизнес-метрики: Собираются метрики для Outbox (
pending_count), Saga (compensation_total), CB (state). -
Jaeger: Видно единое дерево вызовов от API до воркера.
-
SLO/Алертинг: SLO имеет явное окно времени (1 час). Алерты настроены на исчерпание Error Budget (80% за 4 часа) или критические бизнес-события (CB Open > 1 мин).
-
Mermaid-диаграмма: Наглядно показывает точки сериализации/десериализации
trace_id. -
Студент понимает, как Observability проявляется в разных архетипах (финтех, Git, мессенджер, лента).
-
ADR-6: Student сформулировал ADR «Auto-instrumentation vs manual spans» (контекст, альтернативы, решение, overhead-обоснование).
🔗 Мостик к Модулю 7 (Безопасность)
В конце ревью скажи студенту:
- «Отлично, теперь мы видим всю систему как на ладони: трейсы, метрики, логи. Но кто имеет право дёргать наше API? Как защитить Saga от подделки команд? Если злоумышленник перехватит HTTP-запрос с
Idempotency-Keyи отправит его повторно (Replay-атака), наша система из Модуля 2 послушно спишет деньги второй раз. В Модуле 7 мы закроем вопросы IAM, Keycloak, HMAC-подписей и ротации секретов, чтобы сделать систему не только наблюдаемой, но и безопасной. Мы также посмотрим, как безопасность влияет на Observability: какие данные можно логировать, а какие — нет.»
Если ты прошёл курс «Git Hosting: Serverless MVP», ты уже видел этот паттерн на упрощённом стеке: Cloud Monitoring вместо Prometheus, Jaeger через OTLP, cost-алерты на free-tier лимиты. Паттерн тот же — инфраструктура разная. Здесь мы разбираем его на полном стеке, с глубиной и trade-offs.
Как это выглядит на живом сервисе — «Мультипоточность в Go», модуль 5 и практика алертов на стенде — «Архитектурный полигон», модуль 6: там правило на симптом включается и проверяется машинно.